

Neváhejte a napište
nám zprávu.
Celý článek na webu Události EXTRA
Česko – Tým datových analytiků v Brně pracuje na pokročilých metodách strojového učení aplikované v oblasti finančních trhů. Vědecko-výzkumný projekt, který spustilo několik organizací sdružených pod Asociací komunikačních nástrojů a IOT, přináší první výsledky.
Algoritmy automatizovaně vyhodnocují vývoj trhu a doporučují vhodný postup pro získání investiční výhody oproti standardní Buy&Hold strategii pro indexy americké ekonomiky. Americké indexy je možné koupit i v ČR prostřednictvím tak zvaných ETF (Exchange traded funds). Zvyšující se zájem o tento typ finančních aktiv oznamují přední čeští finanční brokeři. Pokračovat ve čtení na webu Události EXTRA
V dnešním článku se podíváme na to, jak hluboko do matematických základů pravděpodobnosti se náš tým musí ponořit při tvorbě svých optimalizačních řešení.
Generátory náhodných čísel
Generátor náhodných čísel je základním kamenem v mnoha optimalizačních a výpočetních algoritmech. Například Monte Carlo metody, algoritmy simulující evoluci, nebo nastavení počátečních vah v hlubokých učících se sítích. Stále je v této oblasti mnoho neznámého jak nástroje správně používat. A obvyklá lidská intuice selhává.
Ideální generátor náhodných čísel má rovnoměrné rozložení generovaných čísel a mezi jednotlivými čísly není žádná návaznost.
Typy
Skutečně náhodné generátory
Na nízké úrovni jsou skutečně náhodné události všude okolo nás – nazýváme je šumem.
Atmosférický šum je rádiový šum způsobený atmosférickými procesy – každý ho může zažít, když naladí rádiový přijímač na frekvenci, kde žádná ze stanic nevysílá. Ostatní mohou být termální, elektromagnetické a kvantové události – kosmická radiace, radioaktivní rozpadu částic nebo tak jednoduchého, jako je šum způsobený různými událostmi na PN přechodu polovodičů.
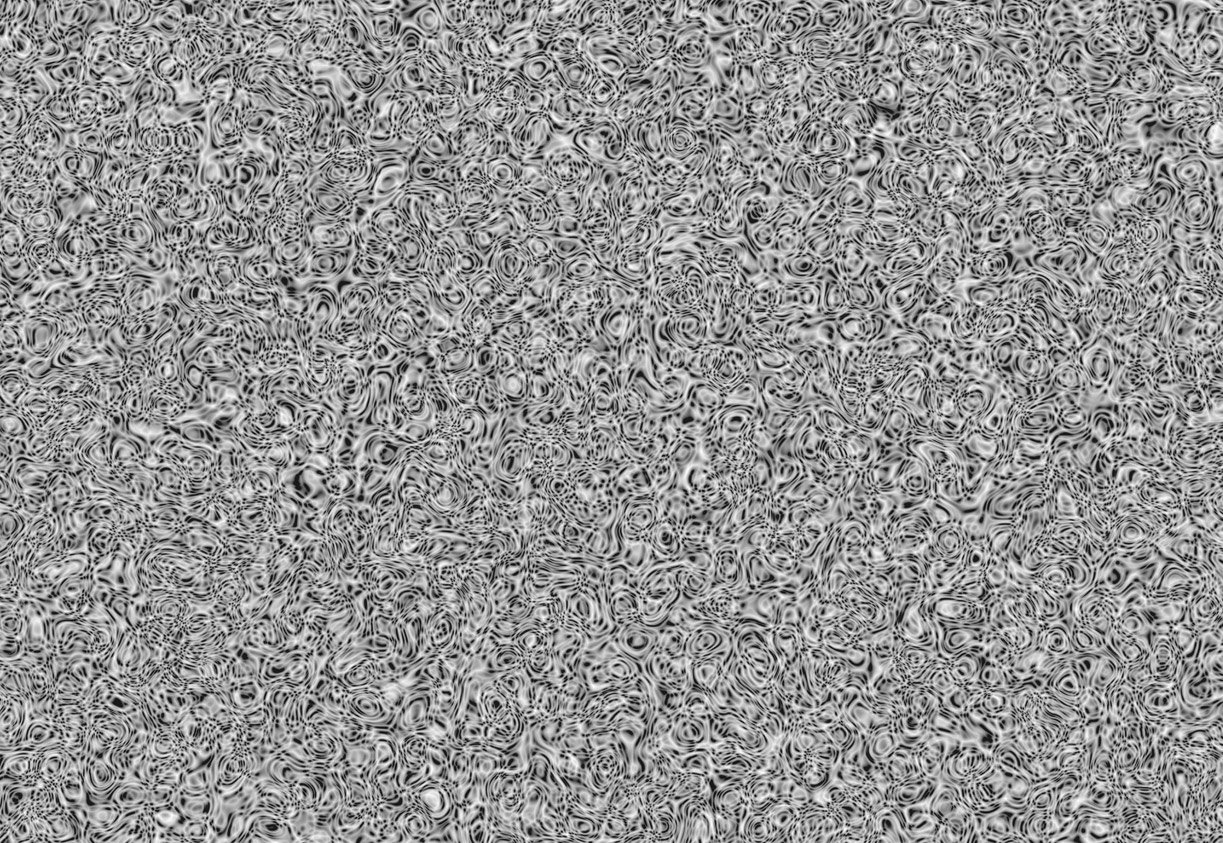
Bílý šum
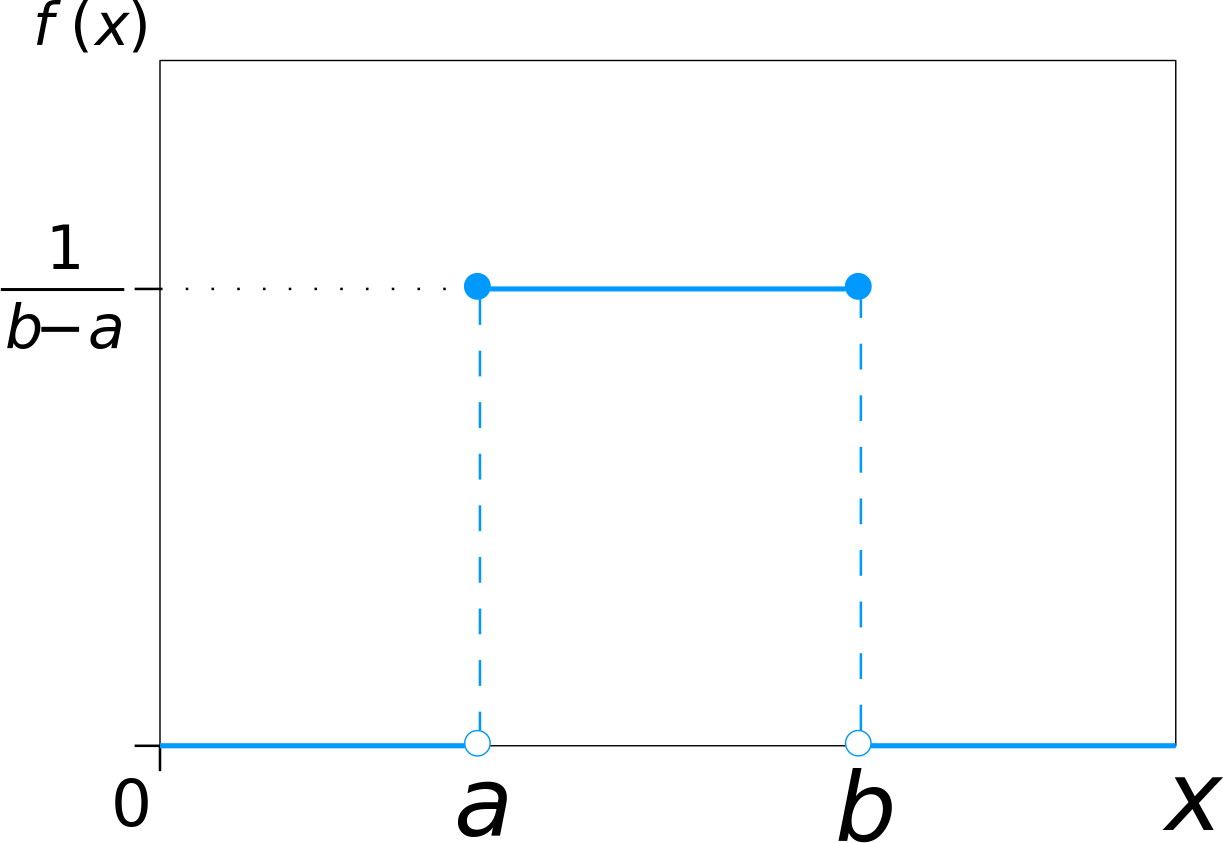
Distribuce hodnot bílého šumu
Pseudo náhodné generátory
V oblasti výpočetní techniky se snažíme co nejvíce eliminovat šum. Počítače jsou však velmi přesné, exaktní, což je přesně to, co nepotřebujeme při práci s nahodilostí.
Pro získání něčeho náhodného, počítač vyžaduje sběr náhodných událostí z jeho okolí nebo ze specifického hardwaru se skutečně náhodným generátorem.
Příklady událostí produkovaných ve výpočetní oblasti jsou čas (velmi omezené použití), zpoždění mezi stiskem kláves na klávesnici, měřením pohybů myši, zpoždění mezi komponentami a moduly na síťových rozhraních atd. Čím je větší sbírka těchto událostí, tím lepší je entropie pro vektor inicializace pseudonáhodného generátoru.
Jinými slovy – čím déle počítač běží, tím je větší entropie pro pseudonáhodný generátor.
V programování
Existuje mnoho způsobů, jak inicializovat generátor náhodných čísel seed hodnotou. Když ale vyvíjíme program, je nezbytné, abychom mohli porovnávat jednotlivé verze chování programů mezi sebou. Je vhodné nastavit generátor náhodných čísel na stejný “seed”, aby program běžel vždy stejně a dodával stejné výsledky.
Náhodná intuice
Lidský svět je poháněn většinou normálním distribučním procesem.
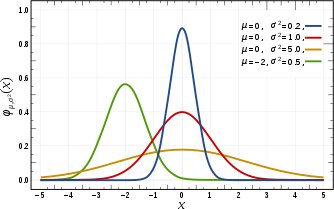
Normální distribuce
Normální rozdělení v sobě nese velmi nízkou pravděpodobnost extrémních událostí. Ve financích je obvykle náhodná odchylka 2 a vyšší považována za extrémní událost. Nicméně obecně se v literatuře důrazně doporučuje nepoužívat normální distribuci a s ní spojenou standardní směrodatnou odchylku. Jak bylo zdokumentováno, finanční trh je spíže poháněn Poissonovým nebo jinými procesy s mnohem vyššími hodnotami na okrajích rozdělení (fat tails).
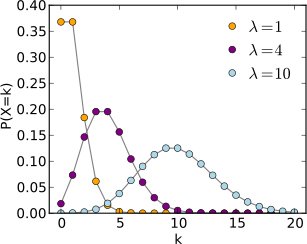
Poisonova distribuce
Lidské intuice předpokládá normální rozdělení a rozhodně nic takového jako je ploché rozdělení bílého šumu (= extrémní hodnoty přichází častěji než lidská intuice postavena na konceptu normálního rozdělení předpokládá).
Náhodnost v evolučních algoritmech
V oblasti financí a obchodování je prostým důkazem evoluční genetický algoritmus, který dokáže najít chyby v procesu zpětného testování. Například pokud existuje chyba, která umožňuje nahlédnout do budoucnosti …obvykle to trvá jen desítky generací, zjistit a využít tuto chybu. Lidská intuice by předpokládala, že se může stát, že evoluční algoritmus, takovou chybu nemusí najít. Naše zkušenosti dokládají, že ji najde vždy.
Zároveň lidsky optimalizovaný přístup k vytváření dat a ukládání do mezipaměti je nesmyslný. Genetický algoritmus z definice bude samozřejmě zkoumat všechny typy dat, které jsou k dispozici pro vyhledávání pravděpodobnostního řešení v celém vícerozměrném prostoru. Bez nízkých hodnot pravděpodobnosti na okrajích distribuce rozdělení…
Jak často očekávat nečekané lze vyjádřit pomocí entropie, jejíž opomíjení je největší příčinou nerobustnosti finančních modelů a obchodních systémů. Respektování její existence zvýší robustnost a vypovídací hodnotu našich řešení.
Miloň Krejča
Dokončili jsme návrh mobilní aplikace orientované na koncového zákazníka, který hledá zobecněný názor diskutovaný v recenzích k danému produktu. V obchodě před regálem s různým zbožím tak nebude muset pročítat desítky recenzí na srovnávačích cen.
Ochutnávka grafického návrhu


Předchozí článek k našemu software
Stáhli jsme přes 1 milion recenzí
Pro další informace nebo poskytnutí zpětné vazby nás neváhejte kontaktovat.
Jeden z předcházejících příspěvků „Principy práce s RelativeValues Lab„se věnoval stručnému popisu dílčích problémů, které by měl software pro tvorbu obchodní strategie založené na obchodním přístupu Relative Value, umožnit řešit. Klíčovým krokem takové strategie je identifikace dvojic dostatečně podobných aktiv. To je velmi nekonkrétní pojem a proto i tento krok lze realizovat různými postupy. Aby mohly být vyhledané dvojice co nejstabilnější, má smysl nejprve provést odfiltrování aktiv, která jsou pro párové obchodování nevhodná, protože mají jen velmi málo společného (technicky, ekonomicky, politicky atd.) i přes to, že jejich chování může být dočasně (náhodně) podobné. Prvotní výběr lze provést prostřednictvím různých snadno dostupných ukazatelů (deskriptivních a fundamentálních, ale i technické ukazatele lze pro tyto účely použít). Mezi předvybranými kandidáty se pak hledají dvojice těch, kteří se historicky dlouhodobě pohybovali co nejvíce společně.
I pro vlastní testování spolupohybů ve dvojicích časových řad lze použít několik postupů založených na různých matematických a statistických metodách:
- korelace změn hodnot – jedna z historicky prvních metod pro detekci potenciálních párů, která již byla stručně představena v jednom z předcházejících příspěvků „The Relative Value Approach“ a detailnější souhrn analýzy jejích výstupů byl uveden jiném příspěvku „Walk forward test of correlated pairs„
- minimalizace vzdáleností – spolupohyb je hledán jako nejnižší suma čtverců rozdílů normalizovaných řad
- kointegrační analýza – jedna řadu v páru je lineární kombinací druhé řady
- analýza náhodného rozpětí – předpokládá, že rozdíl cen osciluje kolem dlouhodobého průměru
Výstup analýzy korelací mezi změnami hodnot časové řady vypovídá o síle shody společných pohybů, takže řady s vysokou korelací změn hodnot se tak mohou vzájemně vzdalovat (např. obě rostou, přičemž jedna roste rychleji) a už se nemusí k sobě přiblížit.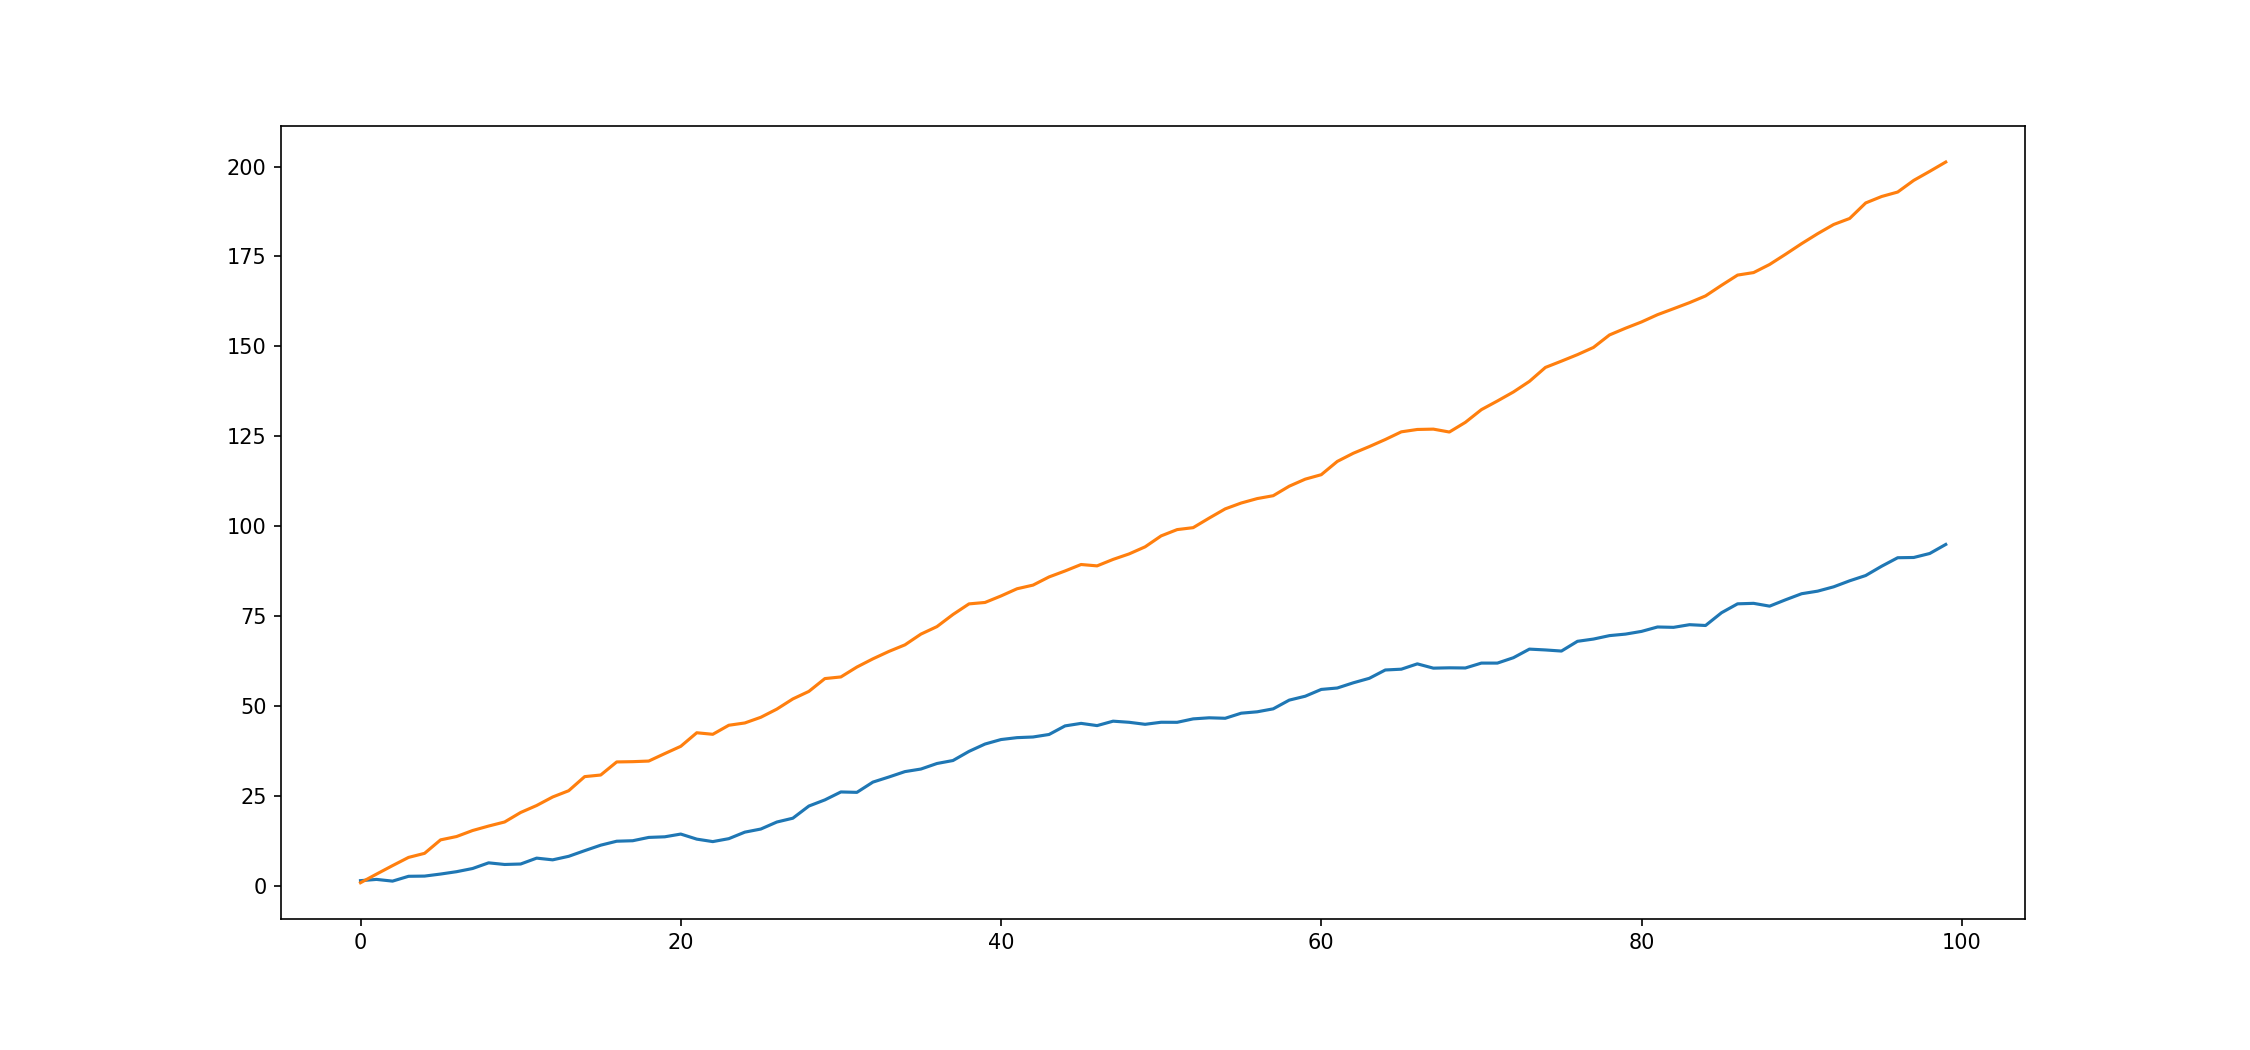 Pro párové obchodování je však žádoucí situace, kdy časové řady se po dočasném oddálení vzájemně k sobě opět přiblíží, což přítomnost vysoké korelace změn hodnot nezaručuje. Tento jev vzájemného přitahování časových řad je schopna lépe identifikovat kointegrační analýza.
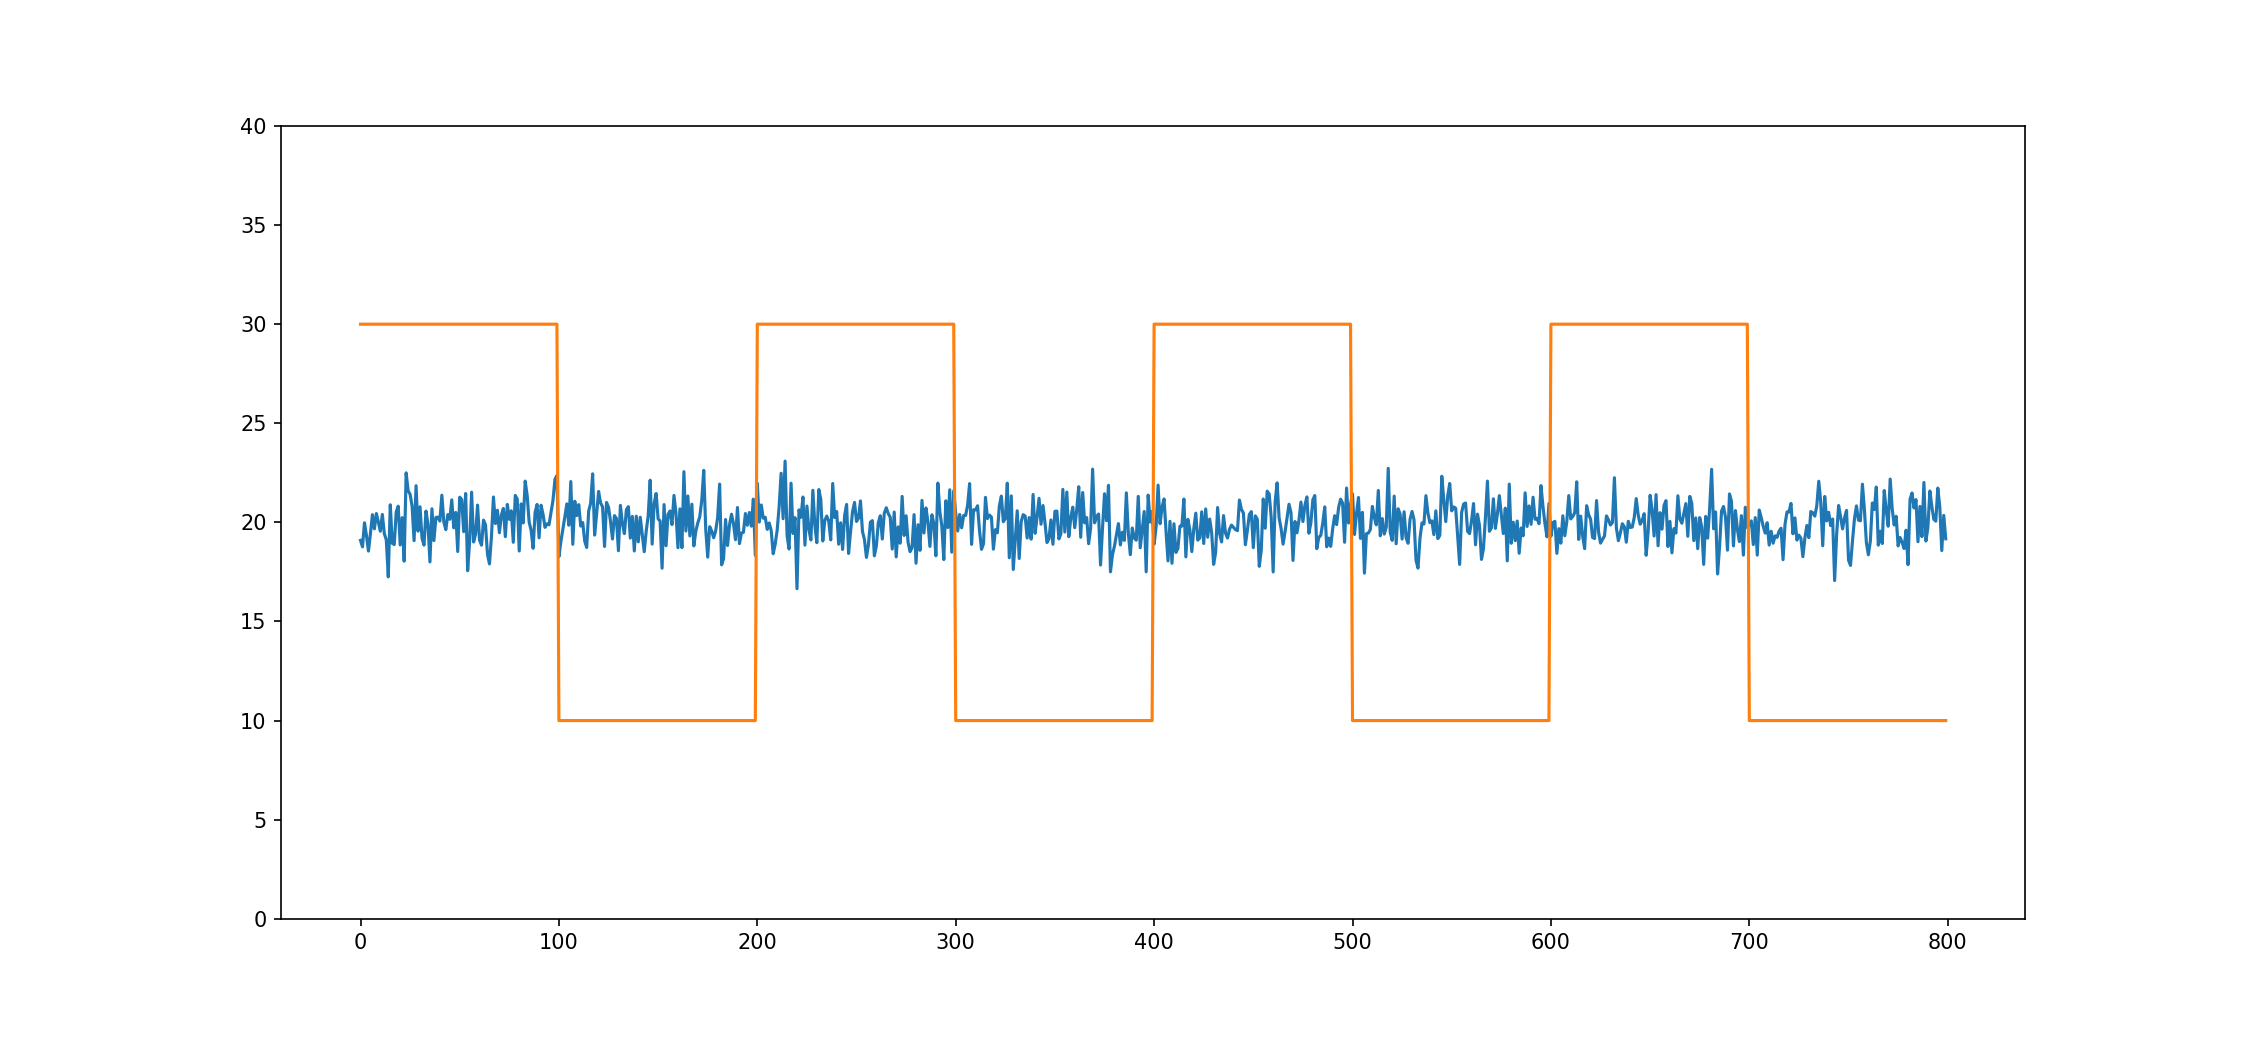 Analýzu korelací změn hodnot tak lze použít jako jeden z prvotních filtrů pro výběr kandidátů, mezi nimiž jsou pak hledány dvojice vhodné pro párové obchodování.
Kointegrační analýza je nejběžnějším současným přístupem používaným k identifikaci párů. Opírá se o statistický koncept stacionárních náhodných procesů, což jsou procesy, které jsou bez trendu, mají s měnícím se časem stejný rozptyl a stejný průběh autokorelační funkce. Většina finančních časových řad však tyto vlastnosti nesplňuje, jde tedy o procesy nestacionární, přesto lze při hledání společného chování časových řad využít testování stacionarity.
Obecně platí, že lineární kombinace dvou nestacionárních časových řad vyústí opět v nestacionární časovou řadu. Pokud jsou ale časové řady generovány stejnými nebo velmi podobnými procesy, je možné, že některá lineární kombinace těchto řad vyústí ve stacionární řadu. Základní myšlenkou kointegrační analýzy je tedy nalezení takové dvojice nestacionárních časových řad, jejichž lineární kombinace vytvoří časovou řadu stacionární. Aby bylo možné považovat řady za kointegrované, rezidua z nalezené lineární kombinace řad musejí být stacionární.
Pro časové řady vstupující do analýzy se často, kvůli předpokladům pro použití určitých metod, používají různé transformace jako např. normalizace, logaritmy původních hodnot či klouzavé průměry. Nejznámější metodou pro hledání lineární kombinace je tzv. metoda nejmenších čtverců, lze však využít i tzv. metodu úplných nejmenších čtverců (ortogonální regresi). Testováním stacionarity řady (reziduí) se zabývá mnoho testů jednotkového kořene, nejznámějším zástupcem je ADF test, PP test či KPSS test. Pro kvalitnější rozhodnutí je vhodné provést KPSS test a některý z dalších testů tohoto typu (ADF). KPSS test se od ostatních liší konstrukcí nulové hypotézy (hledá důkazy pro nestacionaritu, zatímco ADF a další pro stacionaritu), pokud se testy shodnou, je velmi vysoká pravděpodobnost, že závěr skutečně platí.
Vedle testování stacionarity reziduí z nalezené lineární kombinace je vhodné provést i prostou analýzu frekvence návratů řady ke své střední hodnotě, resp. doby mezi dvěma protnutími. Výhodou této analýzy je skutečnost, že cílí přímo na konkrétní vlastnost řady, která je z praktického pohledu pro účely párového obchodování nejdůležitější. Nalezená dvojice vykazující stacionaritu reziduí může mít tak nízkou četnost návratů ke střední hodnotě, že pro párové obchodování bude nezajímavá, jelikož u takového páru by bylo nutné držet pozice otevřené příliš dlouhou dobu, což z pohledu řízení rizika může znamenat problém. Stacionarita sama o sobě zde tedy tak silný význam nemá, významnější je spíše jeden z jejích projevů: vysoká četnost návratů časové řady ke své střední hodnotě.
Po nalezení dvojic s vlastnostmi blížícími se ideálním požadavkům (s rezidui z lineární kombinace, která jsou stacionární a mají dostatečně vysokou frekvenci návratů ke střední hodnotě) lze však s jistotou předpokládat, že tyto vztahy nebudou trvat věčně. Za vhodné období pro opakování procesu hledání párů se běžně doporučuje uplynutí 6 měsíců.
Naďa Chalupová
Finanční trhy jsou známé pro svou pravidelnou změnu chování z hlediska velikosti volatility, změny trendů či stagnace a to z důvodu velkého množství kvalitativních i kvantitativních vstupů, které nelze často jednoduše identifikovat. I přesto lze ale nalézt vzory vývoje ceny u některých assetů a s určitou pravděpodobností předpovědět budoucí vývoj ceny a využít této informace pro podporu investičního rozhodování (otevření nebo uzavření obchodní pozice).
Analýzu vzorů chování finančních instrumentů lze rozdělit do tří základních kategorií:
- analýza vzorů historických průběhů cen (cenové vzory)
- analýza fundamentálních informací (earnings, news, ekonomické ukazatele)
- analýzy psychologie davu (teorie her, chování davu)
Tyto tři kategorie jsou vzájemně propojeny a doplňují se. Historický průběh cen v sobě obsahuje footprint psychologie davu i fundamentálních informací.
Náš tým aktuálně pracuje na nástroji PatternLab, který dokáže automatizovaně vyhledávat a statisticky vyhodnocovat vzory chování ceny. Pomocí jednoduchého formuláře si uživatel vybere požadovaný vzor a seznam assetů pro analýzy. Vzory jsou rozděleny do několika kategorií – indikace zvýšení volatility, pokračování aktuálního trendu nebo obrat trendu.
Uživatel PatternLab
Uživatelem PatternLab je ten, kdo potřebuje pravidelně v rámci investičního rozhodování využít tvrdá statistická data a nespoléhat pouze na své intuitivní rozhodování. Typickým příkladem je portfolio manažer, který řídí obchodní pozice stovek klientů a jeho rozhodnutí může mít velký dopad na stav obchodních účtů, jeho kredibilitě a další akvizice nového kapitálu.
Příklad použití
Portfolio manažer je v situaci, kdy se rozhodne po 10 měsících uzavřít obchodní pozice na vybraném assetu. Pomocí PatternLabu provede analýzu a dostane statistické vyhodnocení o tom, že pokud obchodní pozici neuzavře ihned, ale počká ještě 5 dní, tak s vysokou pravděpodobností vydělá ještě dvě procenta navíc.
PatternLab může být samozřejmě použit retailovým obchodníkem, makléřem nebo marketingovým oddělením pro snažší komunikaci s klienty při akvizici nebo komunikaci aktuálního stavu obchodních pozic.
Unikátnost
Unikátnost PatternLabu leží v expertním know-how vzorů chování, které jsou výsledkem desetileté aplikace v procesu investičního rozhodování. Nejde tedy o přeoptimalizovaný výstup, ale o ověřenou expertní znalosti kombinovanou s pravidelnou statistickou analýzou.
Jan Budík
V dnešním příspěvku se podíváme na to, jak se z výstupů výzkumné činnosti stává uživatelská aplikace.
Aplikace je plánována jako modulární, kde každý modul bude pokrývat nějaký obchodní přístup. Každý modul bude mít formalizovaný výstup definovaný danou obchodní strategií: backtest a detailní analýzu (s grafy a metrikami). Uživatel si tak může vytvořit vlastní strategii volbou vstupních parametrů.
Jedním ze zmíněných obchodních přístupů je Relative value, který je založen na sázkách na konvergenci v případě, že se zvětší nesoulad mezi podobnými nebo stejnými akciemi. To znamená vyhledání příležitosti využít odchylek v ceně nebo poměru stejných nebo podobných cenných papírů. Předpokládá se, že rozdíly jsou pouze krátkodobé a že poměr cen se brzy vrátí zpět na původní (normální) míru. Fondy s relativní hodnotou jsou vnímány jako zajištěné fondy, jelikož neobchodují pouze cenu určitého cenného papíru samostatně a strategie, která využívá cenových nesrovnalostí, je koupit jeden cenný papír (považovaný za podhodnocený) a prodat druhý (považovaný za nadhodnocený) ve formě párového obchodování.
Uživatel (správce fondu) vytvoří tento druh obchodní strategie v několika základních krocích:
- výběr vhodných párů
- identifikace situací vedoucích k obchodním příkazům
Přijetím této univerzální metodiky vznikne řada otázek a aplikace by měla umožnit správci fondu je vyřešit.
Není pochyb o tom, že fáze výběru vhodných párů je rozhodující. Potenciální správce fondu musí najít dva cenné papíry, které jsou dostatečně podobné. Ve fázi přípravy dat pro tuto analýzu je nutné zabývat se problémy jako:
- jaké historické období je třeba brát v úvahu pro výběr párů
- jaké ukazatele (technické, fundamentální atd.) a jakou roli budou hrát při detekci podobnosti, např. najít aktiva, která se historicky pohybovala společně
- určit, co považovat za obvyklé rozdíly (podobnost)
- jak naložit s páry, kde jsou jednotlivá aktiva příliš podobná (téměř stejná) u zvažovaných ukazatelů (pravděpodobně nebudou generovat žádnou příležitost pro arbitráž)
- která aktiva podle některých (fundamentálních, technických a dalších) faktorů vzít nebo vyloučit z úvahy
Dalším krokem v procesu výběru párů je provést vlastní analýzu připravených dat. Zde jsou otázkami hlavně:
- jaký přístup nebo algoritmus použít pro výpočet podobnosti – široce známé a používané jsou kointegrace, korelace, regrese apod.
- vyhodnotit robustnost/sílu páru (celkovou, v různých obdobích)
- stanovit přísnost podmínek pro identifikaci páru
- kolik nejméně párů je vhodné mít v portfoliu
- jak naložit s aktivy, která se účastní více párů
- jakou roli mohou hrát nadcházející fundamentální události (fúze, bankrot apod.) ve stabilitě identifikovaného páru
Po rozhodujícím kroku výběru párů následuje obchodní část strategie. Jde o určení obchodních signálů, tj. definici pravidel řešících problémy, jako jsou:
- jak moc se aktiva v páru mají lišit pro vstup do obchodních pozic
- existují další relevantní ukazatele vyvracející vhodnost vstupu do plánované pozice (plánován nákup a RSI indikuje přehřáté aktivum atd.).
- určit poměr aktiv v otevíraných pozicích
- jak velká odlišnost aktiv by už měla vést k výstupu z pozic
- jak dlouho maximálně čekat na to, až se rozdíl vrátí do normálního stavu nebo se pozice uzavře bez ohledu na obchodní výsledek (zamezení možným vyšším ztrátám)
Naďa Chalupová